 Oltre Turing
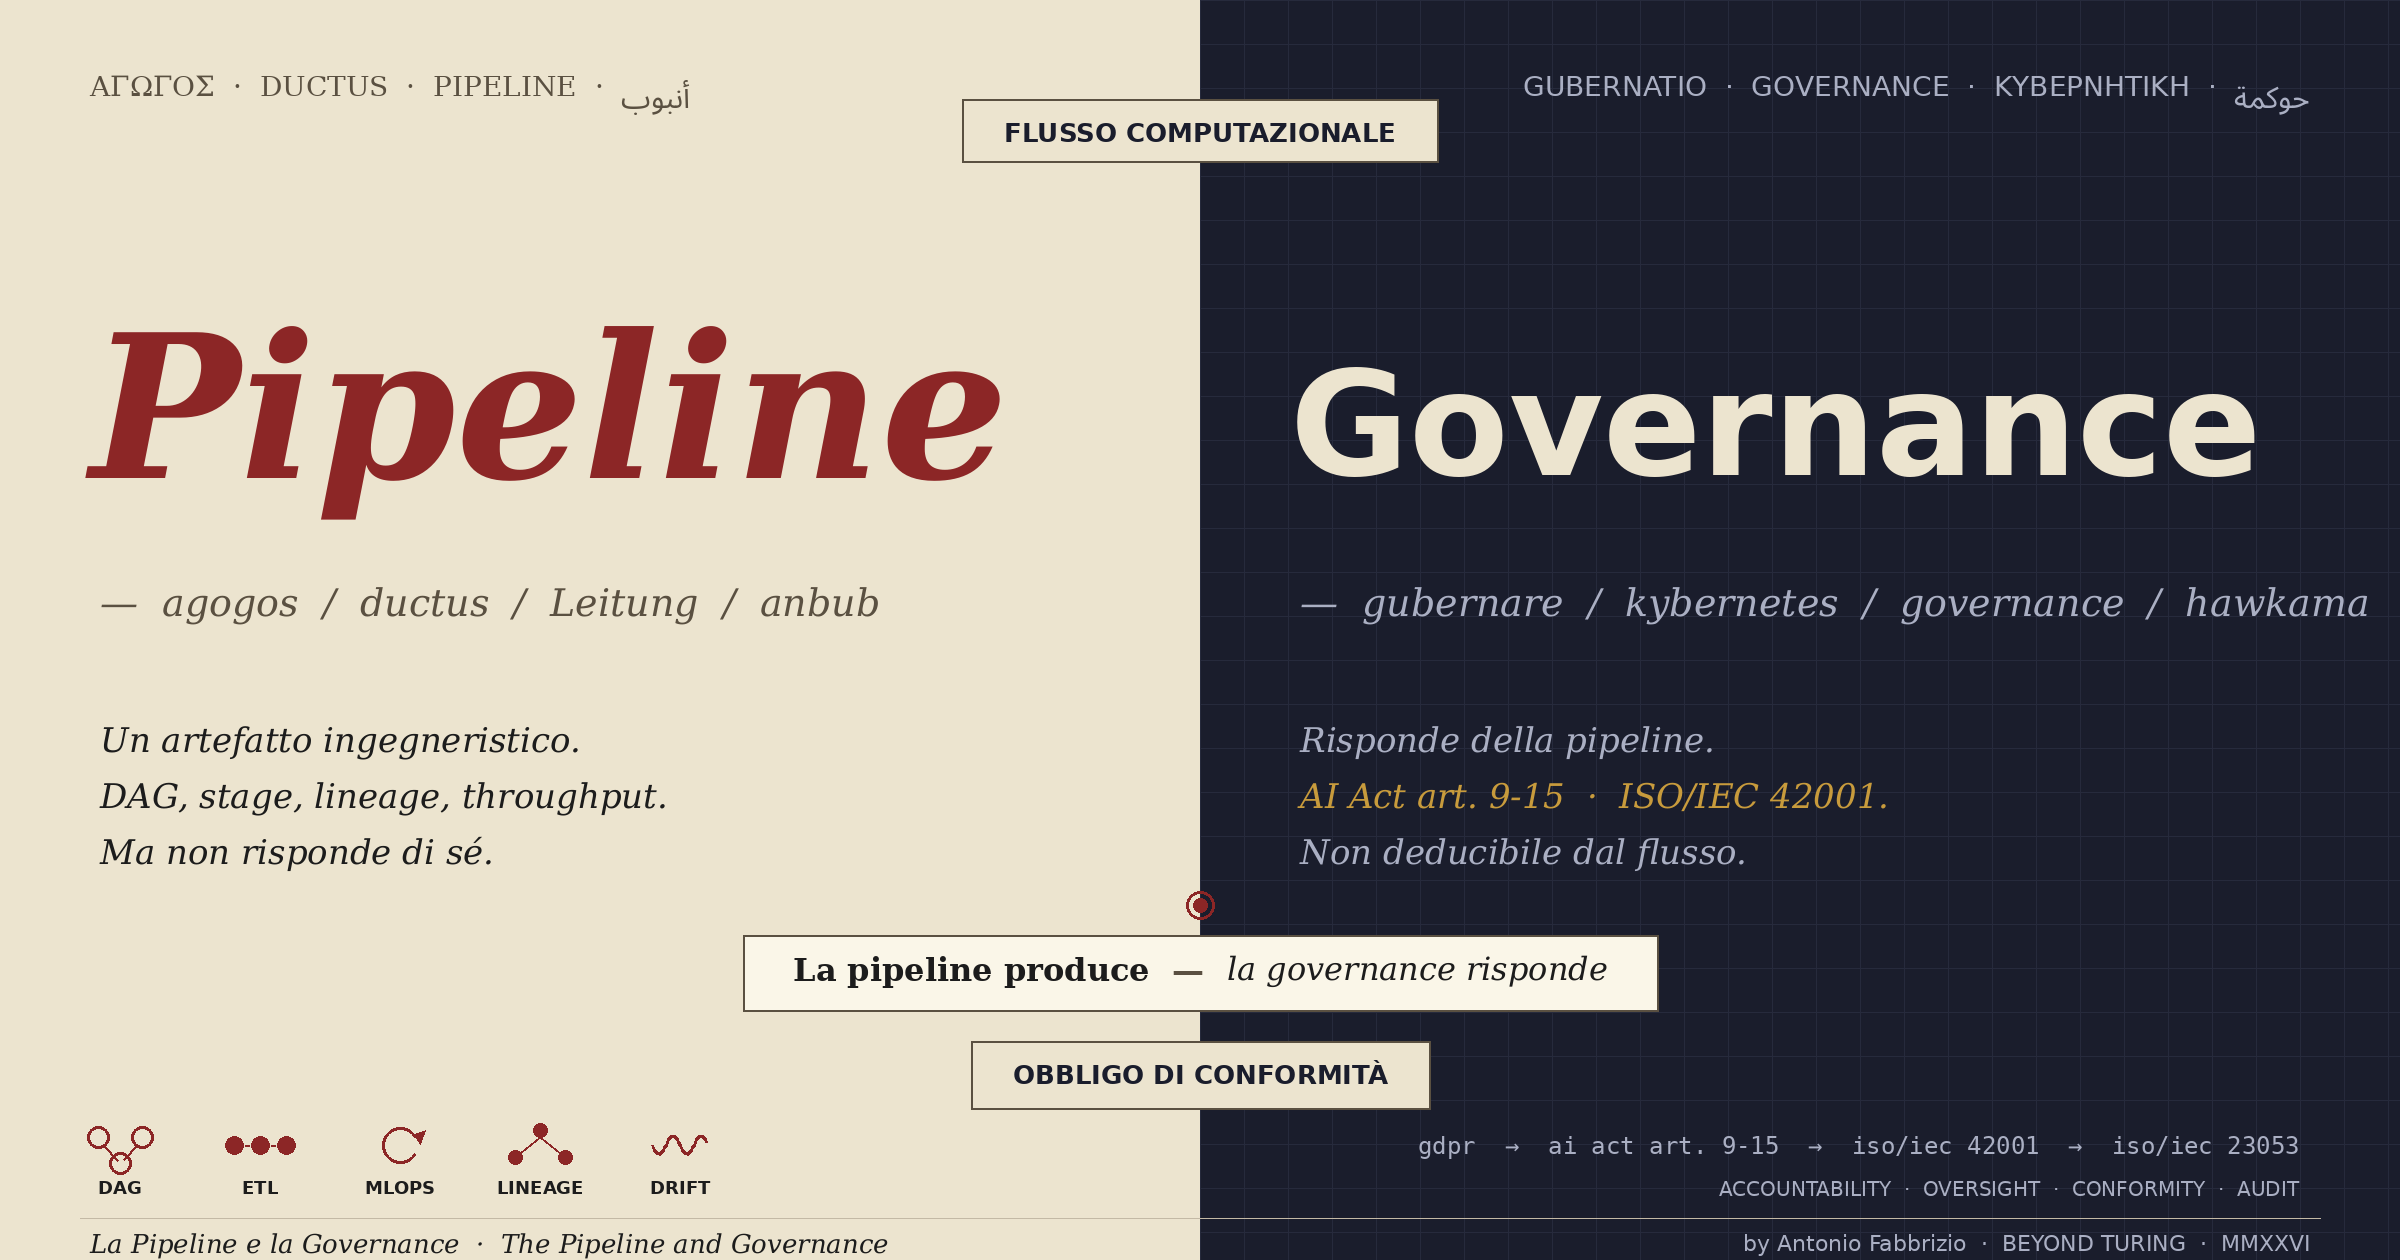
Una qualunque architettura di apprendimento automatico in produzione - un sistema di scoring creditizio, un classificatore di immagini diagnostiche, un raccomandatore in un sistema informativo aziendale - è oggi composta da due livelli operativamente distinti ma normativamente inseparabili: una pipeline computazionale, che orchestra la trasformazione dei dati in modelli e dei modelli in decisioni, e un apparato di governance, che ne disciplina la progettazione, l'esercizio, il monitoraggio, la revisione.
Lo spostamento categoriale è sottile ma decisivo. La pipeline è un artefatto ingegneristico - DAG, stage, dipendenze, lineage, throughput, latenza. È specificabile, versionabile, riproducibile, ottimizzabile. Funziona o non funziona, secondo metriche misurabili. La governance non è un altro stage della pipeline, né una sua estensione: è l'ambiente regolatorio entro cui la pipeline si lascia progettare. Non funziona. Risponde.
Questo capitolo traccia l'architettura di tale tensione dal punto di vista dell'ingegnere dei sistemi informativi che progetta, valida e governa pipeline ML in regime di Regolamento UE 2024/1689 (AI Act), Regolamento UE 2016/679 (GDPR) e standard ISO/IEC 42001:2023. La tesi metodologica è che l'integrazione pipeline-governance non sia un sovrapposizione di due viste sullo stesso oggetto, ma il riconoscimento di due piani che richiedono primitive ingegneristiche distinte.
1. La pipeline come artefatto ingegneristico
Nella letteratura MLOps consolidata (Sculley et al., 2015; Paleyes, Urma, Lawrence, 2022; Kreuzberger, Kühl, Hirschl, 2023), una pipeline di apprendimento automatico è un grafo diretto aciclico - un DAG - i cui nodi sono unità computazionali e i cui archi codificano dipendenze di dati e di esecuzione. Le primitive operative sono note: data ingestion, feature engineering, training, validation, evaluation, packaging, deployment, monitoring, retraining. A ciascuno stadio corrispondono metriche ingegneristiche verificabili: throughput, latency, freshness, model drift, prediction skew, feature staleness.
La maturità del settore ha prodotto strumenti standardizzati. Apache Airflow, Kubeflow Pipelines, MLflow, Tecton, Feast non sono soltanto framework: sono incarnazioni concrete di un'epistemologia operativa per cui ogni trasformazione del dato deve essere tracciabile, riproducibile, deterministica nei limiti del possibile. La metodologia DataOps integra questo approccio sul versante dei dati (Atwal, 2019); la pratica del feature store impone un'astrazione di catalogo verificabile sul materiale di training e inference.
Fin qui la pipeline è, a tutti gli effetti, un artefatto ingegneristico neutro: una sequenza di operazioni con input, output, metriche di servizio e SLA. Una gestione ingegneristica accurata è condizione necessaria di qualsiasi sistema in produzione. Non è però condizione sufficiente di nulla che riguardi l'imputabilità delle decisioni che la pipeline produce. Una pipeline può essere costruita impeccabilmente - riproducibile, monitorata, performante - e nondimeno produrre decisioni la cui legittimità non è deducibile dalla sua correttezza ingegneristica.
2. La governance come categoria giuridico-tecnica
Il Regolamento UE 2024/1689 - l'AI Act, entrato in vigore il 1° agosto 2024 e applicabile in modo scaglionato fino ad agosto 2027 - introduce una stratificazione del rischio (art. 6 e Allegato III) e un apparato di obblighi specifici per i sistemi classificati ad alto rischio. Gli articoli 9-15 costituiscono il nucleo operativo: risk management system continuativo (art. 9), data and data governance per i set di addestramento, validazione e test (art. 10), technical documentation conforme all'Allegato IV (art. 11), automatic logging dei record di esecuzione (art. 12), trasparenza verso i deployer (art. 13), human oversight architettato (art. 14), accuracy, robustness e cybersecurity (art. 15).
Lo standard ISO/IEC 42001:2023 - primo standard internazionale per AI Management Systems - fornisce il framework certificabile per implementare un sistema di gestione conforme. ISO/IEC 23053:2022 definisce il framework architetturale per sistemi AI basati su ML; ISO/IEC 23894:2023 specifica la gestione del rischio; ISO/IEC 5338:2023 normalizza il ciclo di vita. Insieme, questi quattro standard costruiscono l'infrastruttura tecnica che traduce gli obblighi dell'AI Act in deliverable ingegneristici verificabili: risk register, conformity assessment, post-market monitoring plan, incident reporting procedure.
Per il doppio regime del Software as a Medical Device - MDR e AI Act insieme - vale quanto visto nel capitolo sul dato e il soggetto; sul piano documentale il coordinamento è oggetto di guidance specifica della Commissione Europea (MDCG 2019-11, in revisione).
Queste non sono cornici astratte. Sono, letteralmente, checklist di deliverable ingegneristici: documenti tecnici versionati, procedure di logging automatico, audit trail tracciabili, log di drift e di accuracy nel tempo, evidenze di consultazione umana in punti decisionali architetturalmente identificati. La governance, in questo senso, non è meta-livello concettuale: è un secondo strato operativo che richiede primitive ingegneristiche proprie.
3. Architetture di sorveglianza umana e auditabilità
Il capitolo sul dato e il soggetto ha mostrato perché l'art. 14 dell'AI Act - human oversight - sia la prescrizione più rilevante dal punto di vista architetturale, e come si traduca in tre topologie di controllo umano. Qui interessa il suo risvolto operativo: la scelta della topologia non è puramente normativa, è dimensionamento di sistema.
Il human-in-the-loop prevede un operatore umano che convalida ciascuna decisione prima dell'esecuzione: è il modello più conservativo, applicabile dove la latenza ammessa lo consente e il volume decisionale è gestibile. Il human-on-the-loop pone l'operatore in modalità di monitoraggio attivo, con possibilità di intervento e correzione asincrona - è il modello tipico dei sistemi raccomandativi a volume elevato. Il human-in-command mantiene l'autorità umana a livello strutturale - regole di ingaggio, poteri di disattivazione, perimetri operativi - e ammette l'esecuzione autonoma del singolo output, compensata da audit campionario sistematico ex post (Schmidt, 2022; Sterz et al., 2024).
La scelta tra le tre topologie non è puramente normativa: è dimensionamento di sistema. Incide su latenza ammissibile, throughput sostenibile, costi operativi, organizzazione del personale di supervisione, dimensionamento del log storage. Il documento di architettura deve giustificare la scelta - l'AI Act è esplicito sul punto: la sorveglianza deve essere proporzionata al rischio, e la proporzionalità è documentabile.
La sorveglianza umana richiede inoltre che il modello sia spiegabile nei limiti imposti dal compito. La letteratura Explainable AI (Guidotti et al., 2019; Arrieta et al., 2020) distingue spiegazioni globali (caratterizzazione del comportamento del modello su tutta la distribuzione) da spiegazioni locali (giustificazione di una specifica predizione). Tecniche come LIME, SHAP, Integrated Gradients sono ormai standard industriali. La scelta tra approcci intrinseci (modelli intrinsecamente interpretabili) e approcci post-hoc (spiegazioni applicate a modelli opachi) è essa stessa una decisione di architettura. Da qui la prassi consolidata delle model cards (Mitchell et al., 2019) e dei datasheets for datasets (Gebru et al., 2021), oggi parte integrante della documentazione tecnica richiesta dall'art. 11 dell'AI Act.
4. Lineage, audit trail e tracciabilità verificabile
L'art. 12 dell'AI Act richiede che i sistemi ad alto rischio implementino logging automatico durante l'intero ciclo di vita. Non è un vincolo cosmetico: è prescrizione architetturale. Significa che ogni inferenza di produzione deve essere ricostruibile ex post - quale versione del modello l'ha generata, quale snapshot dei dati di input, quale stato della feature store, quale configurazione di sistema. Il concetto operativo di data lineage (Singh et al., 2018; Polyzotis et al., 2018) diventa, sotto AI Act, evidenza di conformità: non più strumento opzionale di debugging, ma deliverable richiesto in fase di conformity assessment.
L'implementazione tecnica passa attraverso tre componenti integrati: un metadata store che traccia ogni esecuzione della pipeline (MLflow Tracking, Neptune.ai, Weights & Biases ne sono incarnazioni industriali); un model registry che versiona ogni artifact di modello con la sua signature, le sue dipendenze e le sue metriche di validazione; un audit trail immutabile - tipicamente append-only - che registra tutti gli eventi operativi rilevanti, compresi gli interventi di sorveglianza umana documentati ai sensi dell'art. 14.
La sfida ingegneristica è la conservazione coerente di queste tre tracce nel tempo. Un sistema che gira in produzione per cinque anni accumula uno storico di lineage che deve restare interrogabile per la durata complessiva del periodo di conservazione imposto - tipicamente dieci anni per i sistemi sanitari, sette per i sistemi finanziari, ai sensi delle normative settoriali applicabili. Il dimensionamento dello storage di lineage non è secondario rispetto allo storage del dato operativo: in molti casi lo supera in volume.
Una pipeline matura, sotto AI Act, è una pipeline che produce due output paralleli per ogni inferenza: la decisione e la sua tracciabilità. La governance non aggiunge un controllo a valle - modifica la struttura stessa del flusso, imponendo che ogni transizione computazionale produca anche un'evidenza verificabile della propria occorrenza. È un cambiamento di paradigma architetturale che non è ancora pienamente interiorizzato dalle organizzazioni che hanno costruito le proprie pipeline ML prima del 2024.
5. Il resto irriducibile
Nessuna architettura di sorveglianza, nessun audit trail completo, nessuna model card esaurisce la responsabilità del soggetto che ha messo il sistema in produzione. Questo non è un richiamo etico esterno alla disciplina: è una constatazione metodologica. Il logging dell'art. 12 attesta la storia di una decisione; non attesta la sua giustezza. La conformità documentata dell'art. 11 attesta che il processo seguito è stato quello previsto; non attesta che il sistema dovesse essere costruito così. L'oversight dell'art. 14 prevede l'intervento umano; non garantisce che l'intervento sia stato sostanziale.
L'ingegneria matura non cerca di chiudere questo gap: lo dichiara. Lo misura - dove possibile - con tecniche di uncertainty quantification (Abdar et al., 2021), conformal prediction (Angelopoulos & Bates, 2023), out-of-distribution detection. Lo riduce, dove tecnicamente possibile, attraverso architetture di safety-by-design. Ma non lo elimina, perché la responsabilità della decisione è una proprietà del sistema socio-tecnico nel suo insieme, non un attributo distillabile da una qualunque sua componente computazionale.
Il punto metodologico può essere formulato così: la governance del sistema è un invariante di progetto. Non è una proprietà che emerge a valle dalle metriche di performance; è un vincolo iniziale che condiziona lo spazio delle architetture ammissibili. Un sistema progettato senza questo invariante - anche se tecnicamente ottimale - è strutturalmente non conforme. Non perché violi una regola particolare, ma perché ha mancato la categoria entro cui le regole acquistano senso operativo.
Un sistema informativo progettato con questa consapevolezza non rinuncia alla potenza analitica - la rende collocabile. Sa quale parte del proprio comportamento è specificata dalla pipeline e quale parte è invece materia di governance. Sa che la prima si ottimizza, la seconda si argomenta. Sa che ottimizzazione e argomentazione obbediscono a logiche differenti, e che la confusione fra le due genera, alternativamente, iper-controllo paralizzante o sovra-confidenza algoritmica. La maturità ingegneristica consiste nel tenerle distinte senza separarle.
La pipeline si esegue. La governance si abita. Non sono, e non saranno mai, lo stesso tipo di oggetto. Il sistema informativo di cui abbiamo bisogno è quello che lo riconosce - e progetta in entrambi i piani con primitive proprie. Riconoscere il confine non è abdicazione ingegneristica: è la forma più alta di rigore.