 Oltre Turing
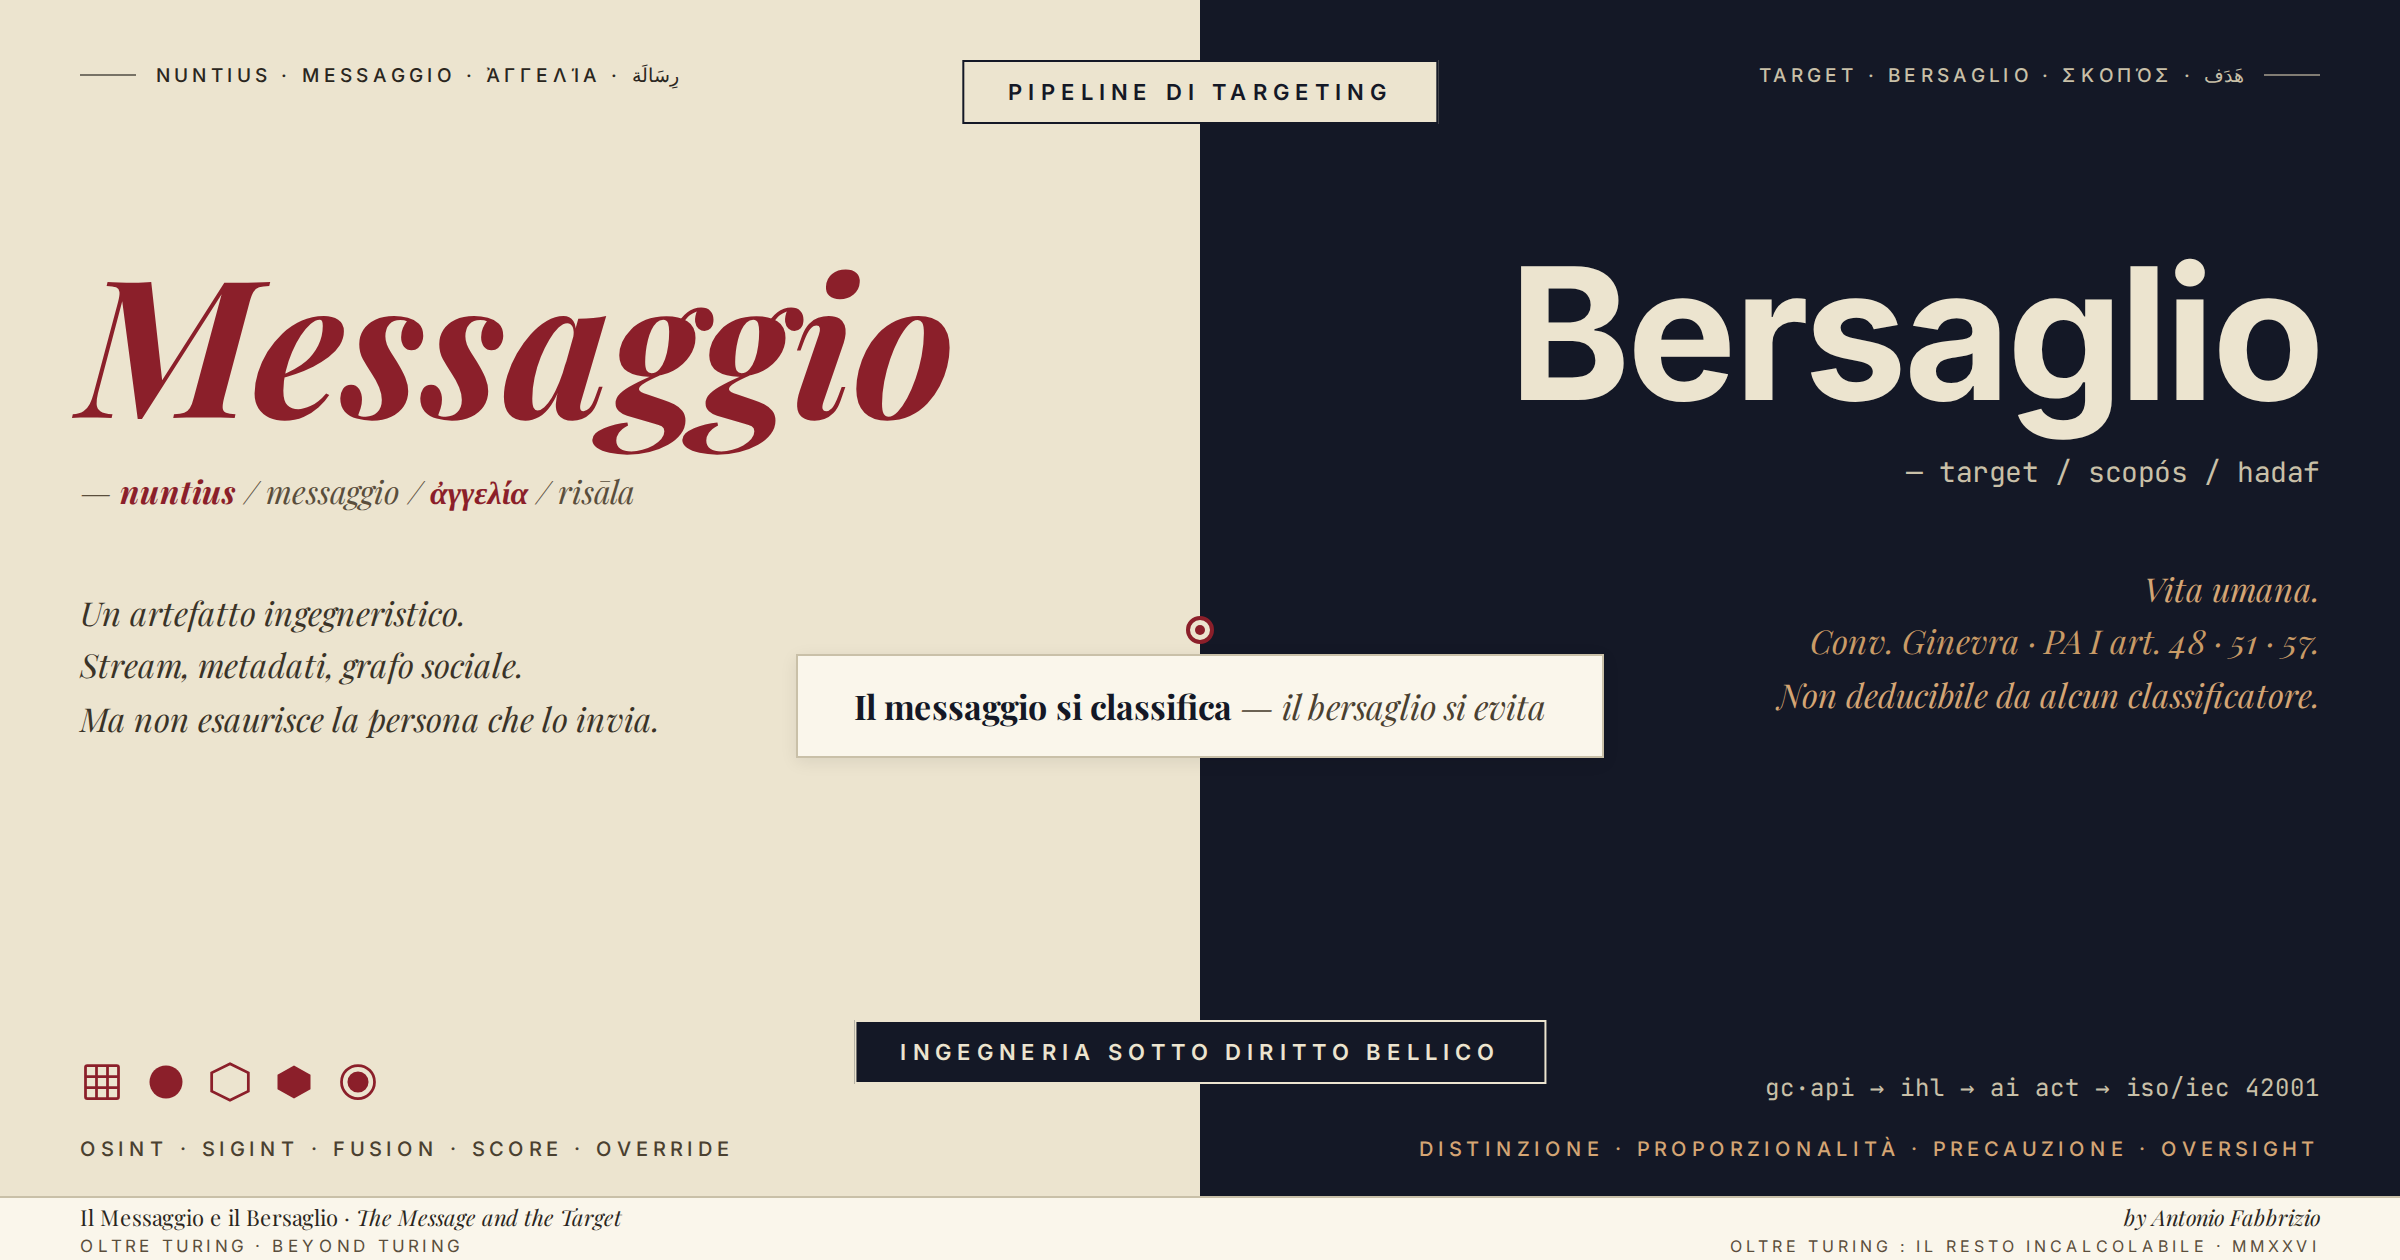
Un sistema informativo militare contemporaneo - una piattaforma di targeting integrata con flussi di intelligence dei segnali, una catena di analisi che fonde intercettazioni di applicazioni di messaggistica con telemetria cellulare e immagini satellitari, una infrastruttura di Big Data che ingerisce decine di terabyte al giorno da sorgenti eterogenee - produce, a regime, output dalla forma sintattica familiare: liste ordinate di entità, ciascuna corredata da un punteggio di confidenza. Ciascuna riga è, formalmente, un record. Ma ciascun record, nel momento in cui designa una persona o un edificio come obiettivo legittimo, costituisce - secondo il Diritto Internazionale Umanitario codificato nel Primo Protocollo Aggiuntivo alle Convenzioni di Ginevra del 1977 - un atto giuridico con conseguenze irreversibili.
Lo spostamento categoriale è netto. Il record è un artefatto ingegneristico - schema, vincoli, lineage, metriche di qualità. Il bersaglio è una categoria giuridica e ontologica - vita umana, principio di distinzione, principio di proporzionalità. L'ingegneria dei sistemi di targeting data-driven vive interamente dentro questa tensione: ogni pipeline che trasforma un flusso di messaggi in una lista di obiettivi è una sequenza di scelte progettuali con conseguenze tecniche, giuridiche ed etiche misurabili - e, in ultima analisi, irreversibili.
Questo articolo traccia l'architettura di tale tensione dal punto di vista dell'ingegnere che progetta, valida o audita sistemi informativi ad alta intensità di dati per applicazioni di sicurezza e difesa. Non è un commento etico sui conflitti contemporanei - è una lettura ingegneristica delle pipeline pubblicamente documentate (Abraham, 2024; McKernan & Davies, 2023), dei loro modi di fallimento, e dei requisiti non funzionali che il Diritto Internazionale Umanitario e l'AI Act impongono a chi le costruisce.
§1. Il messaggio come artefatto ingegneristico
Nella letteratura delle architetture OSINT-SIGINT fusion (Open Source / Signal Intelligence), il messaggio digitale è caratterizzato da una pluralità di dimensioni eterogenee. Il payload testuale è solo una di esse - e spesso non la più informativa. I metadati associati - timestamp, identificativo del mittente, identificativo del destinatario, fingerprint del dispositivo, geolocalizzazione cellulare, latenza di rete, dimensione del messaggio, presenza di allegati - costituiscono ciò che la letteratura tecnica chiama social graph signal: il segnale che emerge dalla topologia delle comunicazioni indipendentemente dal loro contenuto semantico. È un risultato consolidato della network science che il grafo dei contatti, anche in assenza del contenuto, consente di inferire ruoli, gerarchie, prossimità operative con accuratezza notevole (Eagle et al., 2009).
Una pipeline di ingestione tipica articola la gestione di questo flusso lungo stadi canonici: acquisizione streaming (Kafka, Pulsar) dalle sorgenti SIGINT, normalizzazione di schema, arricchimento con sorgenti laterali (anagrafiche, registri telefonici, lawful intercept), persistenza in data lake colonnare (Parquet su S3 o equivalenti), indicizzazione per query a bassa latenza (Elasticsearch, OpenSearch), e - finalmente - esposizione a feature store per l'addestramento e l'inferenza di modelli a valle. Ciascuno stadio possiede metriche ingegneristiche verificabili: end-to-end latency, throughput sostenibile, tasso di drop, completezza referenziale, schema drift rispetto al baseline. Fin qui - e solo fin qui - il messaggio è un artefatto neutro.
La natura del flusso cambia radicalmente nel momento in cui un identificativo è agganciato - direttamente o indirettamente - a una persona fisica. Quell'agganciamento, che nel linguaggio ingegneristico è un semplice join tra due tabelle, è - nel linguaggio del Diritto Internazionale Umanitario - il primo passo verso la qualificazione di un obiettivo militare legittimo ai sensi dell'art. 52(2) del Primo Protocollo Aggiuntivo. La distinzione tra combattenti e non combattenti, sancita all'art. 48 - il principio cardine del Diritto bellico moderno - diventa, in questa fase, una scelta di feature engineering: quali attributi del soggetto giustificano la classificazione, con quale soglia, su quale evidenza, con quale margine di errore documentato.
§2. La pipeline di target acquisition data-driven
Le inchieste investigative di +972 Magazine e Local Call (Abraham, 2024) e del Guardian (McKernan & Davies, 2023) hanno documentato architetture operative di target acquisition algoritmica - denominate, nei materiali interni divulgati, Lavender, Where is Daddy? e The Gospel. Sebbene il dibattito sul loro impiego e sui controlli umani applicati sia tuttora aperto, le caratteristiche tecniche emerse permettono una lettura architetturale di riferimento. Una pipeline tipica si articola in sei stadi sequenziali.
Lo stadio di acquisizione integra sorgenti eterogenee: intercettazioni di messaggistica (Signal, Telegram, WhatsApp metadata laddove accessibile), telemetria delle reti cellulari (CDR - Call Detail Records), tracking di terminali, immagini satellitari ad alta risoluzione, overhead video da piattaforme aeree, sensoristica acustica. Il volume aggregato si misura in petabyte; la velocità in milioni di eventi al minuto. Lo stadio di normalizzazione riconcilia identificativi cross-sorgente: lo stesso soggetto può apparire con un numero MSISDN, un IMEI, un identificativo di account su una piattaforma di messaggistica, un volto rilevato da una telecamera. L'operazione di entity resolution - tecnicamente, un problema di record linkage probabilistico (Fellegi & Sunter, 1969) - è la base su cui poggia tutto il resto.
Lo stadio di feature engineering costruisce vettori di rappresentazione per ciascuna entità: caratteristiche del grafo sociale (centralità, comunità di appartenenza, tie strength), pattern temporali di attività (orari, frequenze, periodicità), pattern di movimento (mobility fingerprint), feature semantiche estratte dal testo via modelli NLP. Lo stadio di scoring applica un classificatore - tipicamente un ensemble di gradient boosting (XGBoost, LightGBM) o reti neurali profonde - addestrato su un dataset storico di entità positive (note ex post come militanti) e negative (note come civili). L'output è uno score continuo che, attraversata una soglia di decisione, produce l'etichetta operativa.
Lo stadio di ranking ordina le entità candidate per priorità operativa, combinando lo score con fattori esogeni (urgenza, finestre di opportunità, vincoli di risorse). Lo stadio di consegna espone la lista a un'interfaccia operativa - tipicamente una dashboard con map view, dettaglio della catena di evidenza, pulsante di azione. Ciascuno stadio è, in astratto, un componente software auditabile. Ciascuno ha - o dovrebbe avere - un proprio model card (Mitchell et al., 2019), una propria documentazione tecnica, una propria suite di test di regressione. La somma di questi componenti è una catena decisionale che termina, in molti casi, con un esito letale.
§3. Il falso positivo come categoria giuridica
Qualsiasi classificatore binario opera con un tasso di errore non nullo. La matrice di confusione - true positive, false positive, true negative, false negative - è il primo strumento didattico in qualsiasi corso introduttivo di apprendimento automatico. Per la maggior parte delle applicazioni civili, la calibrazione del compromesso tra precisione e recall è un esercizio di ottimizzazione condizionato dai costi attesi: il costo di un falso positivo (un cliente inutilmente bloccato da un sistema antifrode, un'email lecita finita in spam) è messo a confronto con il costo di un falso negativo (una transazione fraudolenta consumata, una minaccia non rilevata).
Nella target acquisition la dissimmetria assume una qualità ontologica diversa. Un falso positivo non è un'unità monetaria nella funzione di costo: è - secondo la qualificazione che il sistema stesso opera sull'entità - la potenziale uccisione di un non combattente. Il Diritto Internazionale Umanitario codifica questa asimmetria nel principio di distinzione (art. 48 PI), nel principio di proporzionalità (art. 51(5)(b) PI) e nel principio di precauzione nell'attacco (art. 57 PI). Tradotti in linguaggio ingegneristico, questi principi pongono vincoli formali sulla pipeline: il tasso di falsi positivi è una metrica regolamentare, non solo prestazionale; la confidenza del classificatore deve essere quantificata in modo calibrato (Guo et al., 2017), non solo elevata; la decisione finale di ingaggio deve essere documentata, motivata, riferita a evidenze separabili.
L'AI Act dell'Unione Europea (Regolamento UE 2024/1689), pur dichiarando - all'art. 2(3) - la propria non applicabilità ai sistemi sviluppati o utilizzati esclusivamente per finalità militari, di difesa o di sicurezza nazionale, contiene all'art. 5 un elenco di pratiche di intelligenza artificiale vietate che fornisce comunque un riferimento concettuale. La proibizione del social scoring di persone fisiche (art. 5(1)(c)), della categorizzazione biometrica basata su dati sensibili (art. 5(1)(g)) e del riconoscimento di emozioni in determinati contesti (art. 5(1)(f)) traccia una linea che il legislatore europeo considera intransitabile per applicazioni civili. La domanda ingegneristica che ne discende è precisa: in che misura i sistemi di target acquisition data-driven replicano architetture che il diritto civile europeo ha qualificato come inaccettabili, con la differenza che la loro applicazione è demandata a un regime giuridico - il diritto dei conflitti armati - più tollerante verso l'errore? La risposta non è univoca, ma la domanda è oggi una domanda di progetto.
§4. Sorveglianza umana e accelerazione computazionale
La sorveglianza umana - human oversight - è il presidio architetturale più frequentemente invocato a giustificazione dei sistemi di targeting algoritmici. Nella formalizzazione tipica della letteratura (Cummings, 2004), si distinguono tre topologie. Il human-in-the-loop prevede che ciascuna decisione operativa attraversi una validazione umana esplicita prima dell'esecuzione. Il human-on-the-loop prevede un operatore che monitora il sistema e può intervenire, ma non valida singolarmente ogni output. Il human-in-command prevede che l'autorità umana sia strutturale - regole di ingaggio, perimetri operativi, poteri di disattivazione - anche in assenza di intervento puntuale.
La scelta tra le tre topologie non è una variabile politica: è dimensionamento di sistema. Determina la latenza ammissibile, il throughput sostenibile, il carico cognitivo dell'operatore, le specifiche di interfaccia, il regime di addestramento. Un sistema human-in-the-loop che genera centinaia di candidati al giorno e richiede a un singolo operatore di confermarli individualmente in pochi secondi è - operativamente - un sistema human-on-the-loop che si è autodichiarato in-the-loop. La differenza non è semantica: la stessa pipeline, sotto carico operativo elevato, può collassare da un modello di controllo all'altro senza che nessuno modifichi una riga di codice. È sufficiente che il tempo medio di revisione scenda sotto la soglia di valutazione sostantiva. Il fenomeno è documentato in letteratura come automation bias (Parasuraman & Manzey, 2010): la tendenza dell'operatore a fidarsi acriticamente dell'output del sistema, specialmente in condizioni di alto carico cognitivo, fatica, pressione temporale.
La maturazione ingegneristica di un sistema di targeting passa, dunque, attraverso la definizione formale e misurabile della sorveglianza umana effettivamente esercitata. Non basta dichiarare nei documenti di sistema che esiste un operatore in catena: occorre definire - e tracciare - il tempo medio di revisione per decisione, il tasso di override osservato, la distribuzione dei motivi di override, la correlazione tra override e successivi esiti documentati. Questi dati sono - o dovrebbero essere - parte integrante del logging richiesto dall'art. 12 dell'AI Act per i sistemi ad alto rischio in ambito civile. L'estensione di tale prassi al dominio militare è oggi una questione aperta del Diritto Internazionale, dibattuta in seno al Gruppo di Esperti Governativi delle Nazioni Unite sui Sistemi d'Arma Autonomi Letali (GGE LAWS).
§5. Il resto incalcolabile
Nessuna pipeline, nessuna model card, nessuna topologia di controllo umano esaurisce il soggetto. Questo non è un limite del progetto - è il progetto stesso. Ogni classificatore opera con un coverage gap: una regione del dominio operativo in cui le sue prestazioni non sono state caratterizzate con sufficiente confidenza statistica. Ogni soggetto, al momento di entrare nello scope decisionale del sistema, è - almeno in parte - out-of-distribution rispetto al dataset di addestramento. La singolarità del caso individuale eccede strutturalmente la generalizzazione del modello. Nei sistemi civili questa eccedenza si manifesta come errore correggibile a posteriori. Nei sistemi di targeting essa si manifesta come irreversibilità.
L'ingegneria matura non chiude questo gap: lo dichiara. Lo misura - dove possibile - con tecniche di uncertainty quantification (calibrazione bayesiana, ensemble disagreement, conformal prediction). Lo inscrive nei protocolli di fallback come zona di human deliberation obbligatoria. Lo segnala all'operatore come tale, non camuffato da score di confidenza apparentemente robusto. Queste sono decisioni architetturali concrete, non dichiarazioni di principio. Il rifiuto di dichiarare il gap è - in senso ingegneristico stretto - un errore di progetto. Quando l'errore di progetto opera su decisioni letali, esso diventa una categoria diversa: una mancanza che il Diritto Internazionale Umanitario qualifica, nell'art. 57 PI, come violazione del dovere di precauzione.
Il punto metodologico può essere formulato così: la dignità del soggetto designato come obiettivo è un invariante di progetto. Non è un dato che si misura per definire la soglia di ingaggio; non è una variabile che la pipeline elabora; non è un requisito che si soddisfa con una checkbox di compliance. È una condizione sulla quale il sistema dev'essere costruito fin dal primo commit - con lo stesso rigore con cui si progettano l'alta disponibilità, la consistenza transazionale e la sicurezza crittografica. È il punto in cui il principio di distinzione del Diritto Internazionale Umanitario, l'art. 14 dell'AI Act sulla sorveglianza umana e l'ISO/IEC 42001 sui sistemi di gestione dell'AI convergono in un'unica prescrizione architetturale: un sistema che decide su una vita deve sapere quando non sa, e fermarsi.
Un sistema di target acquisition progettato con questa consapevolezza non rinuncia alla potenza analitica - la rende collocabile. Sa dove opera bene, dove opera male, dove deve passare il controllo a un essere umano che disponga del tempo, della formazione e dell'autorità per esercitarlo. Sa che un soggetto non è la somma dei suoi metadati, così come una pipeline non è la somma dei suoi stadi. Questa coscienza ingegneristica dei propri bordi non è una limitazione della tecnica: è il punto in cui la tecnica raggiunge la propria maturità - e riconosce che ciò che il modello non sa è, talvolta, esattamente ciò che il diritto e l'umanità le chiedono di sapere.
Il messaggio si può classificare. Il bersaglio si può evitare. Non sono, e non saranno mai, la stessa cosa. Un sistema di targeting che riconosce questa distinzione non è meno potente - è meglio progettato. E un'ingegneria che non dimentica questa distinzione non è meno tecnica - è più completa, perché ha compreso che la riga di codice più importante, talvolta, è quella che sospende l'esecuzione.